Эффект бабочки: Как переименование одной строки сломало нашу распределенную систему
· 3 min read
Когда мы проектировали SaaS-версию Flude, мы очень гордились своей архитектурой. Мы разнесли логику по независимым компонентам: ядро парсера (engine), API-шлюз (control-plane), облачные воркеры (job-runner) и тонкие клиенты для интеграции в CI (flude-action и аналоги).
Всё это жило в разных репозиториях и деплоилось независимо. Мы считали, что достигли идеальной “слабой связанности” (loose coupling). Мы были уверены, что изменения в одном модуле никогда не обрушат всю систему.
Пока один безобидный рефакторинг не доказал нам обратное.
Безобидный рефакторинг (Первый взмах крыла)
Всё началось с перфекционизма в репозитории ядра. Я обратил внимание на техническую неточность: наш парсер генерировал не просто классический Markdown, а весьма специфичный диалект с метаданными (frontmatter) и шорткодами, заточенный строго под генератор статики Hugo.
Оставлять формат вывода под общим названием markdown было некорректно — это вводило бы будущих пользователей в заблуждение, если бы они попытались скормить этот код другому генератору (например, Docusaurus).
Я сделал самую логичную вещь в мире: переименовал CLI-аргумент и внутренний идентификатор формата с markdown на hugo_markdown. Тесты ядра ожидаемо позеленели, коммит улетел в main.
Цепная реакция
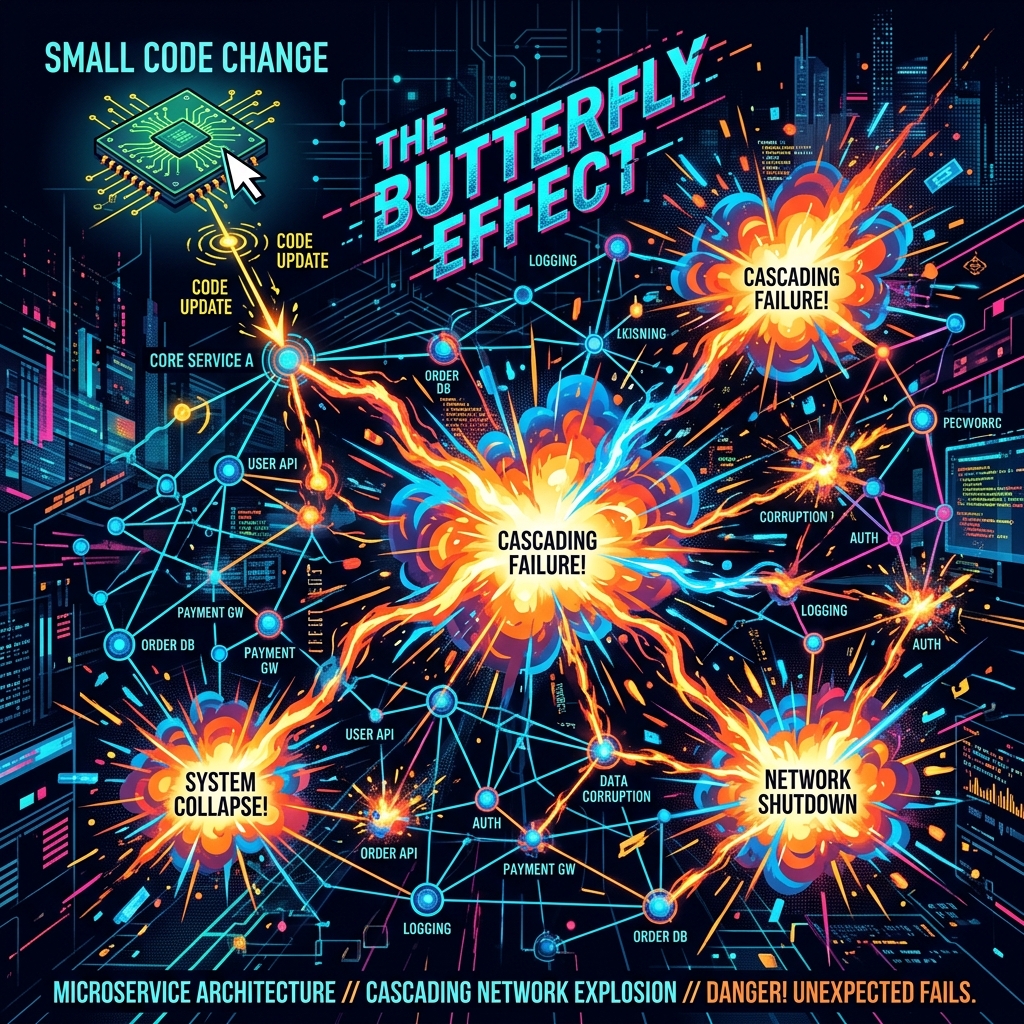
В ту же минуту наша “слабо связанная” микросервисная архитектура начала складываться как карточный домик. Выяснилось, что слово "markdown" было не просто локальной переменной, а негласным жестким контрактом, прошитым во всех слоях системы.
Удар №1: Control Plane
Первым упал API-шлюз, принимающий задания от пользователей. Он внезапно начал отдавать ошибки HTTP 422 Unprocessable Entity. Почему? Потому что на входе стояла строгая OpenAPI-схема, которая валидировала поле format. Схема разрешала только два значения: ["markdown", "html"]. Получив от клиента новый параметр hugo_markdown, API просто отбрасывал запрос как невалидный. Пришлось экстренно патчить схемы валидации.
Удар №2: Облачные Воркеры
Как только API починили и запросы прошли дальше, упали сами воркеры (Data Plane). Воркер успешно запускал обновленное ядро парсера, но после завершения работы пытался найти на диске директорию out/markdown, чтобы запаковать ее в ZIP-архив. Разумеется, папки там не было — ведь обновленный движок теперь заботливо складывал результат в out/hugo_markdown. Воркеры падали с ошибкой FileNotFoundError.
Удар №3: Тонкие клиенты (CI-скрипты)
Воркеры обновили. Архивы начали формироваться. Но пайплайны на стороне пользователей продолжали гореть красным. Наши тонкие клиенты (запускающиеся в GitHub, GitLab и т.д.) отправляли запрос на скачивание артефакта, ожидая получить файл markdown.zip. Сервер же теперь отдавал hugo_markdown.zip. Скрипты просто не находили нужный файл и роняли сборку.
Дорогой урок
Чтобы раскатить переименование всего одной переменной, пришлось координировать синхронный релиз в четырех независимых репозиториях.
В этот день мы выучили важный урок. Микросервисы не спасают от сильной связанности (tight coupling), если ваши контракты основаны на неявных Magic Strings (магических строках), размазанных по коду. Если один сервис меняет формат данных, а другой хардкодит пути к файлам — это не распределенная система. Это распределенный монолит, ломать который гораздо больнее, чем обычный.
Что дальше?
Мы стабилизировали контракты, покрыли их сквозными тестами и, наконец, привели инфраструктуру SaaS в рабочее состояние. Система была готова к реальным нагрузкам.
Но нас не отпускала одна фундаментальная архитектурная проблема ядра, с которой всё и началось — Doxygen. Мы терпели его недостатки: невозможность нормального кэширования AST, медлительность, огромный размер бинарника в контейнерах. Но в один прекрасный день он просто капитулировал перед сложным C++ кодом, и это стало началом конца.
О том, как безобидный шаблонный трюк SFINAE заставлял Doxygen молча удалять классы из проекта, и почему нам пришлось спасаться небезопасными скриптами INPUT_FILTER — читайте в следующем эпизоде.