Реконструкция AST: Как мы вручную пришивали Out-Of-Line методы в libclang
· 3 min read
В прошлом эпизоде мы научили наш нативный парсер на базе libclang находить системные заголовки. Он перестал паниковать и наконец-то прочитал весь код без ошибок.
Но когда мы запустили генерацию документации и начали сверять метрики полноты, мы обнаружили катастрофу. В наших сгенерированных классах не хватало сотен методов. Парсер просто “потерял” их по дороге.
Суть проблемы: Out-Of-Line методы
В C++ правилом хорошего тона считается выносить реализацию методов за пределы объявления класса. Обычно реализация уезжает в отдельные .cpp файлы, а в случае с шаблонными классами — остается в заголовочном файле, но пишется ниже самого класса. Оба варианта называются Out-Of-Line определением:
template<class T> class MyClass {
    void foo();
};

template<class T> void MyClass<T>::foo() { ... }
Старый добрый Doxygen прощал такие вещи: он парсил код как текст и по префиксу MyClass:: легко догадывался, куда положить метод.
Как libclang “теряет” детей
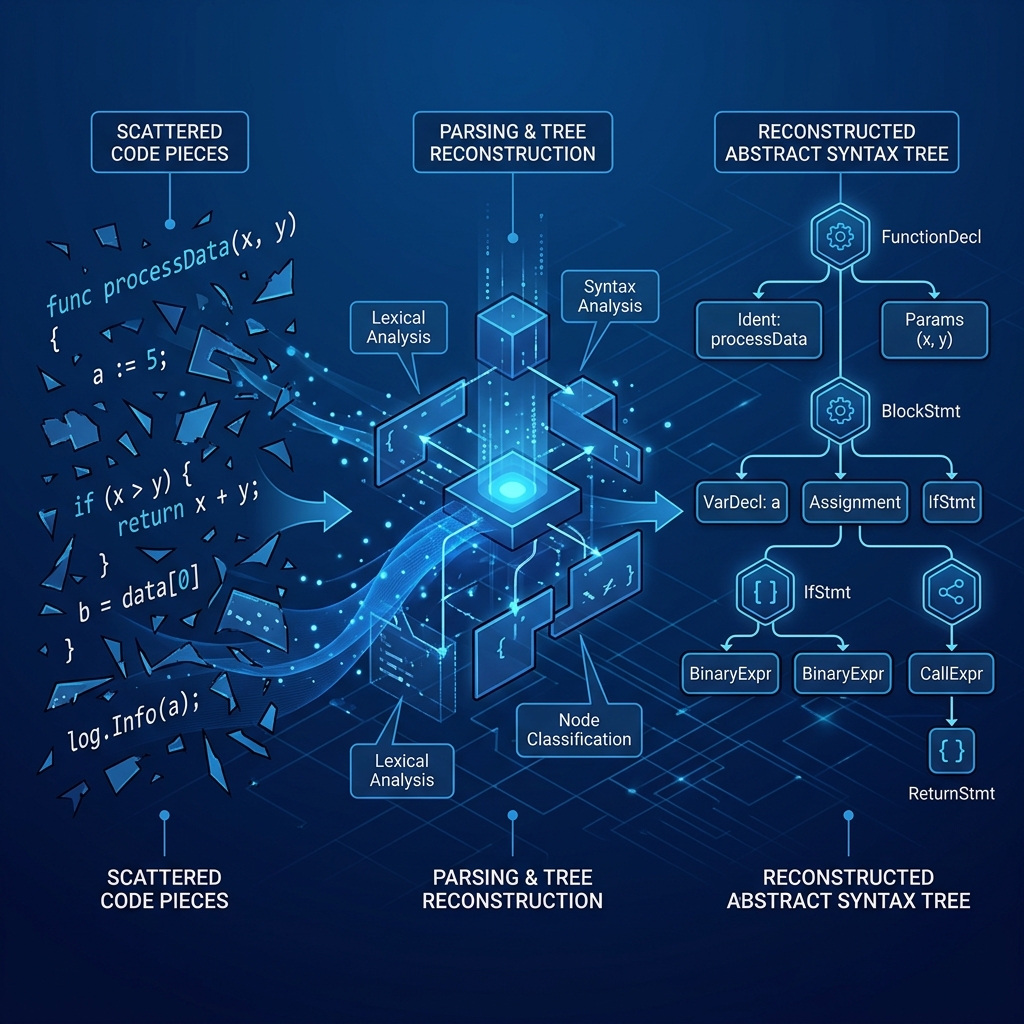
Но libclang строит строгое семантическое абстрактное синтаксическое дерево (AST). В его архитектуре объявление класса — это один узел. А Out-Of-Line метод — это совершенно самостоятельный узел верхнего уровня (Top-level declaration), висящий где-то в глобальной области видимости единицы трансляции.
libclang принципиально не вкладывает этот метод внутрь курсора класса при обходе дерева. В итоге наш скрипт обхода AST видел класс, видел, что внутри него нет узлов с методами, и радостно генерировал пустую страницу документации.
Хирургическая склейка
Чтобы восстановить справедливость, нам пришлось написать собственный алгоритм реконструкции дерева.
Мы завели отдельный проход парсера: мы обходили все “свободно висящие” функции в глобальном скоупе и запрашивали у Clang их семантического родителя (semantic_parent). Если оказывалось, что функция семантически принадлежит какому-то классу, мы брали этот узел и “вручную” пришивали его внутрь нужного класса в нашем промежуточном представлении (ProjectCatalog).
Мы буквально собирали раздробленный код как пазл.
Безымянные конверсии
Но на этом сюрпризы не закончились. Второй болью стали операторы приведения типов к зависимым шаблонам (например, cv::Ptr<T>::operator T*()).
Мы обнаружили, что для таких узлов (с типом CONVERSION_FUNCTION) libclang выдает пустую строку в качестве имени — cursor.spelling возвращал "". То есть метод есть, а имени у него нет!
Нам пришлось написать грязный, но рабочий хак: мы парсили тип возвращаемого значения узла и вручную синтезировали из него строковое имя оператора, чтобы документация выглядела адекватно.
Итог
Эта “сборка мусора” и ручная склейка AST-дерева вернула нам полноту (Recall) по методам до 97.4%.
Мы добились почти идеальной экстракции данных. Настало время применить этот парсер в реальном бою для крупного корпоративного клиента. Мы с самого начала знали о главном жестком требовании бизнеса: вывод нашего современного парсера должен был полностью совпадать с их старым генератором документации. Теперь пришло время реализовать это на практике. О том, как мы выравнивали структуру файлов и роутинг — читайте в следующем эпизоде.